WhisperLocal
Transcrire un enregistrement en texte sans qu'il quitte votre machine : modèle et langue au choix, locuteurs identifiés en option, exports TXT, SRT et DOCX.
Résumé
- Le besoin
- Transcrire des enregistrements rapidement, sans coût récurrent, sans limite de durée imposée et sans confier les fichiers à un service externe.
- Ce que j'ai fait
- Une application Web, de l'upload à l'export.
- Le résultat
- Sur un même enregistrement, un texte quasi identique à celui d'un service en ligne, avec en plus la séparation des voix, sans que l'audio quitte la machine.
Voir l'outil travailler du début à la fin
Le même enregistrement est transcrit deux fois : d'abord par l'application, sur ma machine, puis par un service en ligne, AnySpeech.io. C'est un extrait des Précieuses ridicules de Molière, lu par des bénévoles LibriVox et dans le domaine public. L'attente du traitement local est accélérée dans la vidéo, la mention apparaît à l'écran.
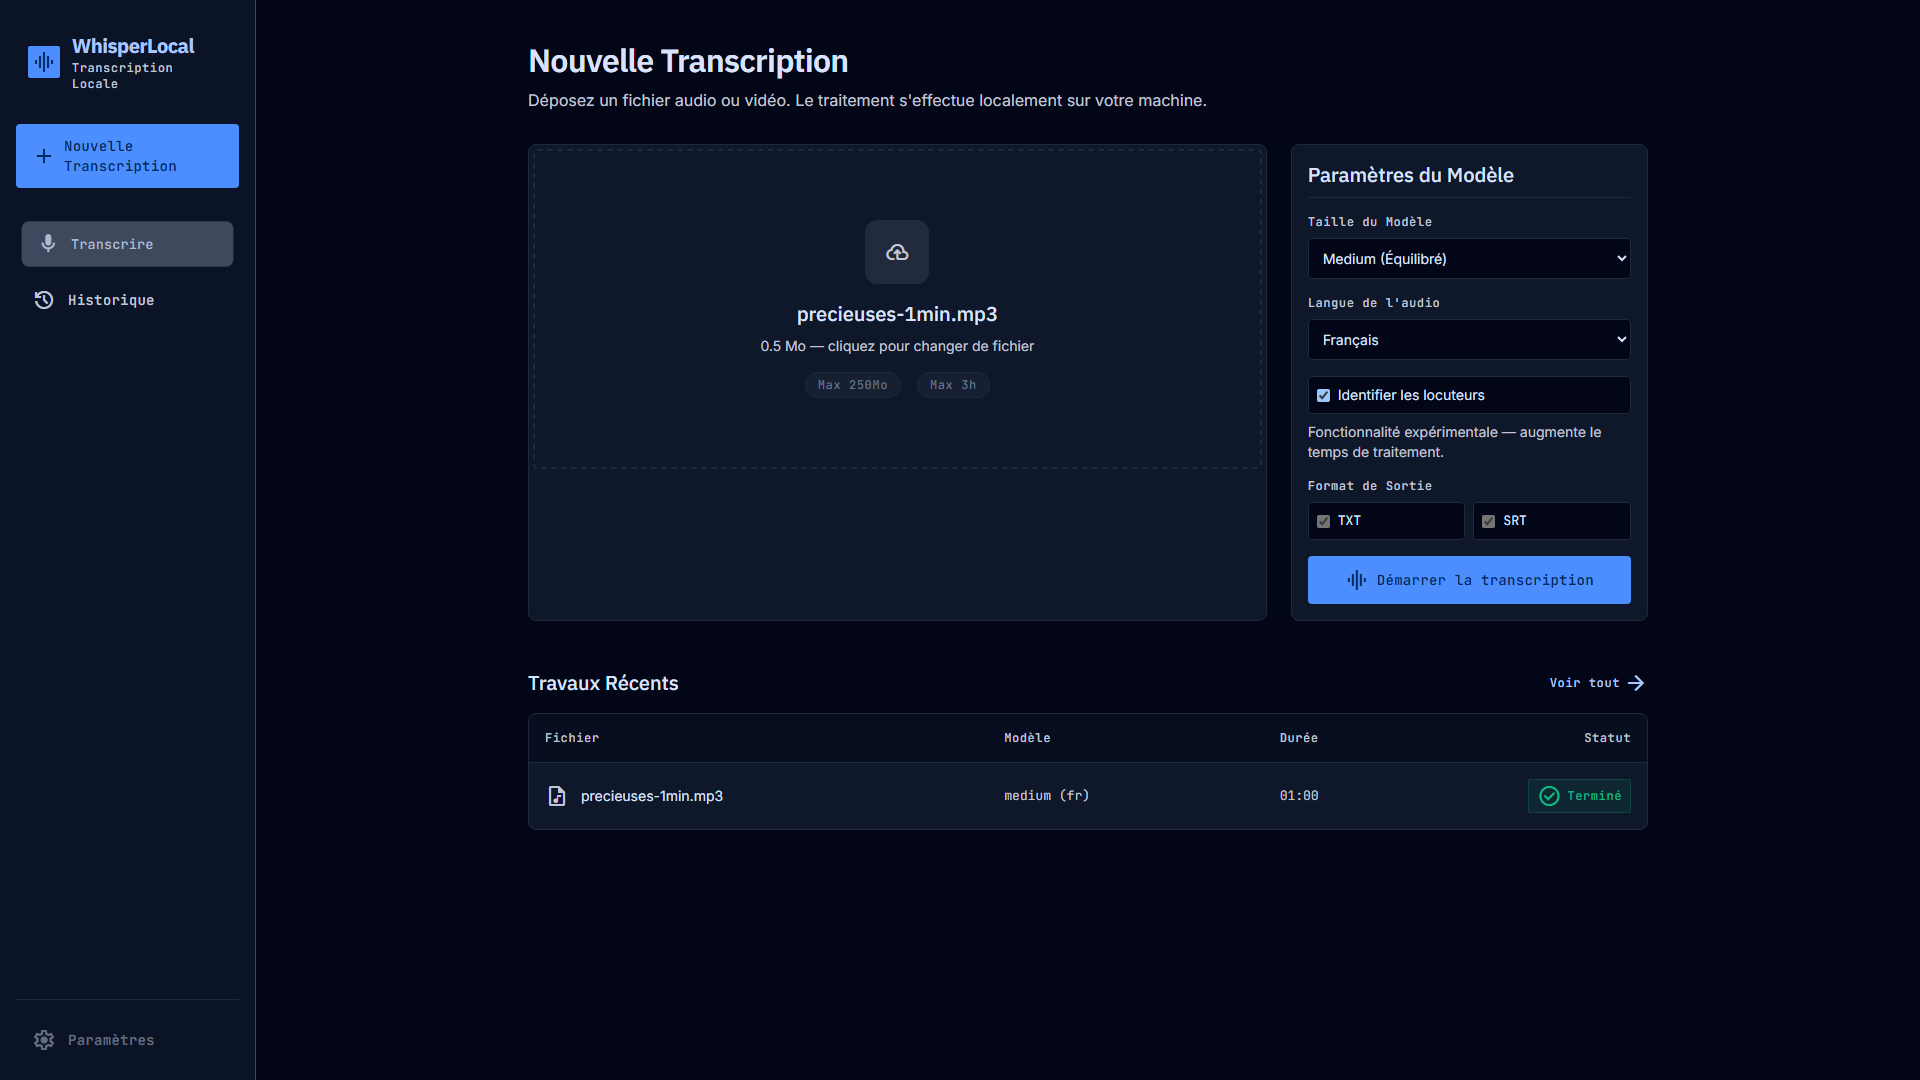
Je dépose un fichier et je règle la transcription
On glisse un fichier audio ou vidéo (250 Mo maximum, 3 h maximum), puis on choisit la taille du modèle, de Base (très rapide) à Large (meilleure précision), et la langue de l'audio ou la détection automatique. Ici : modèle Medium, langue française, identification des locuteurs cochée.
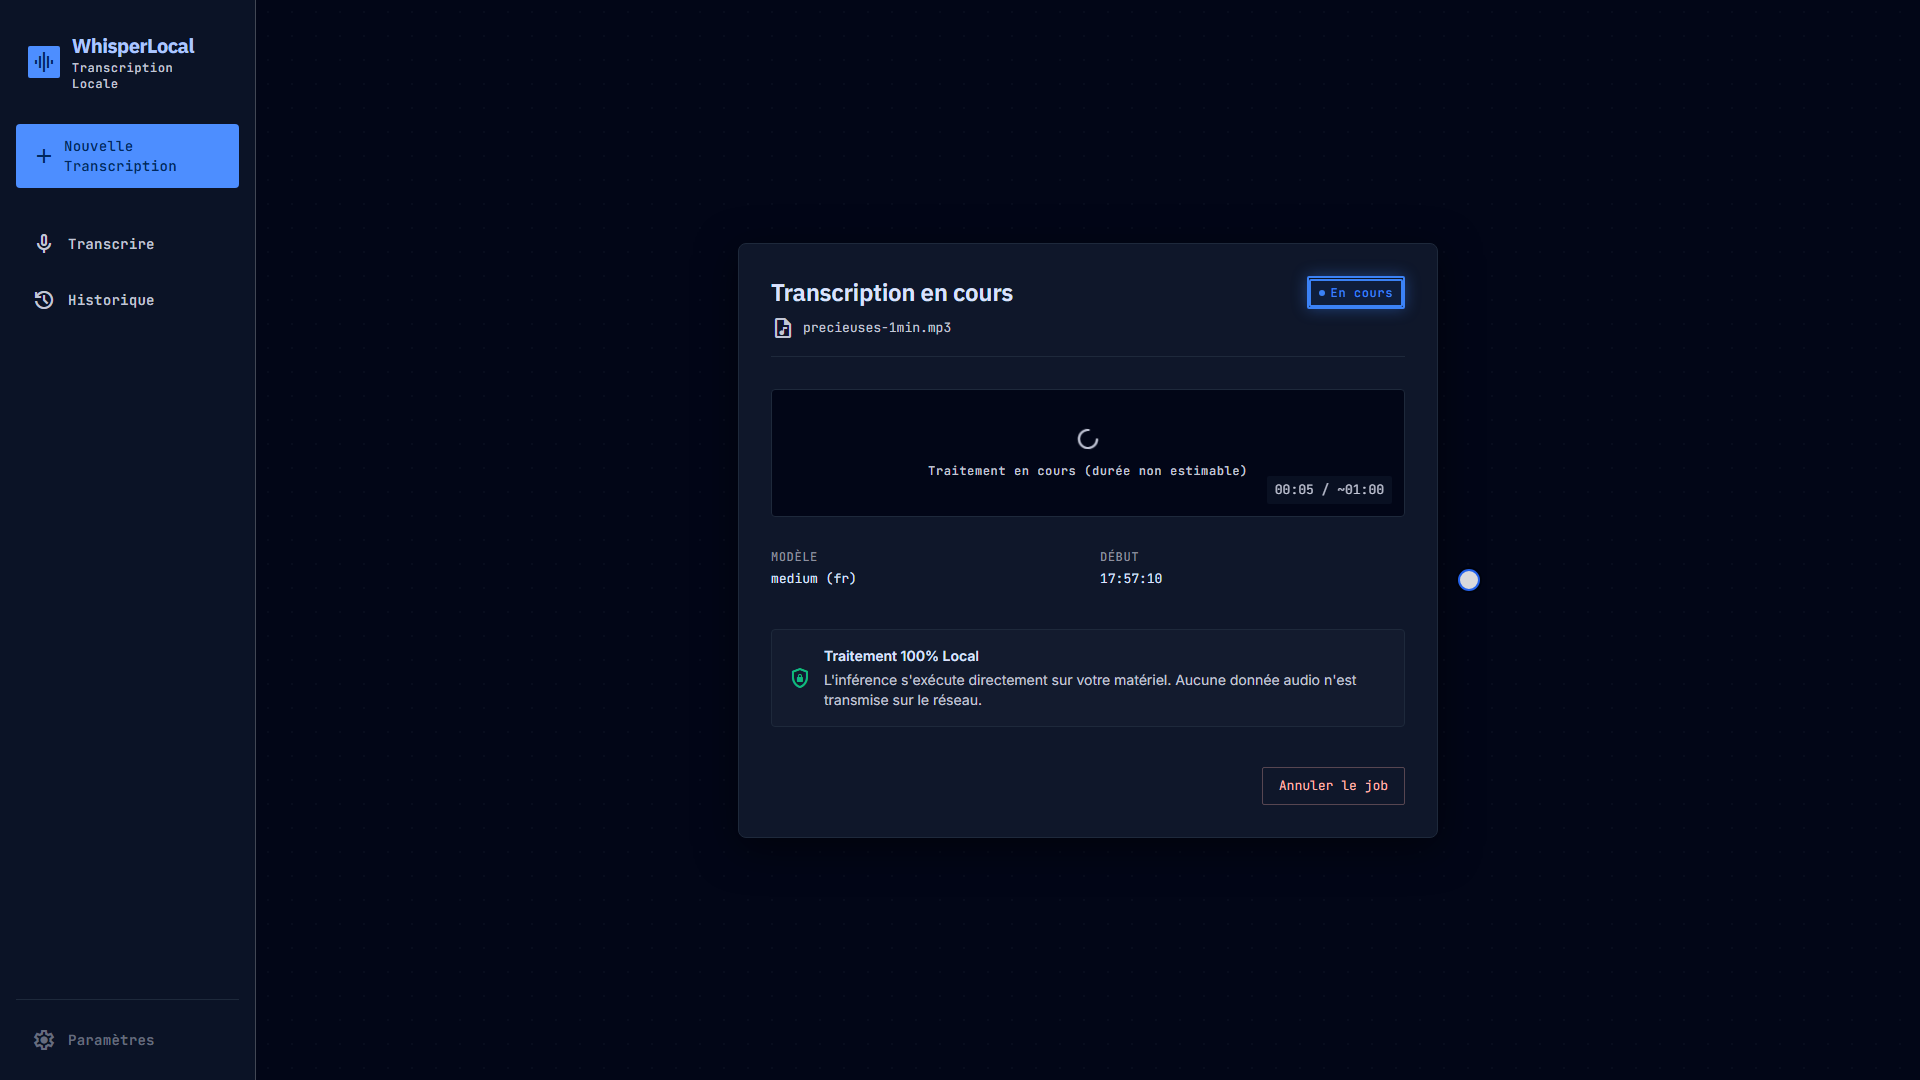
Pendant que la machine travaille
Le fichier est converti puis transcrit sur place, avec un compteur de temps affiché en direct. Un bouton permet d'annuler le job à tout moment, et l'écran rappelle qu'aucune donnée audio n'est transmise sur le réseau.
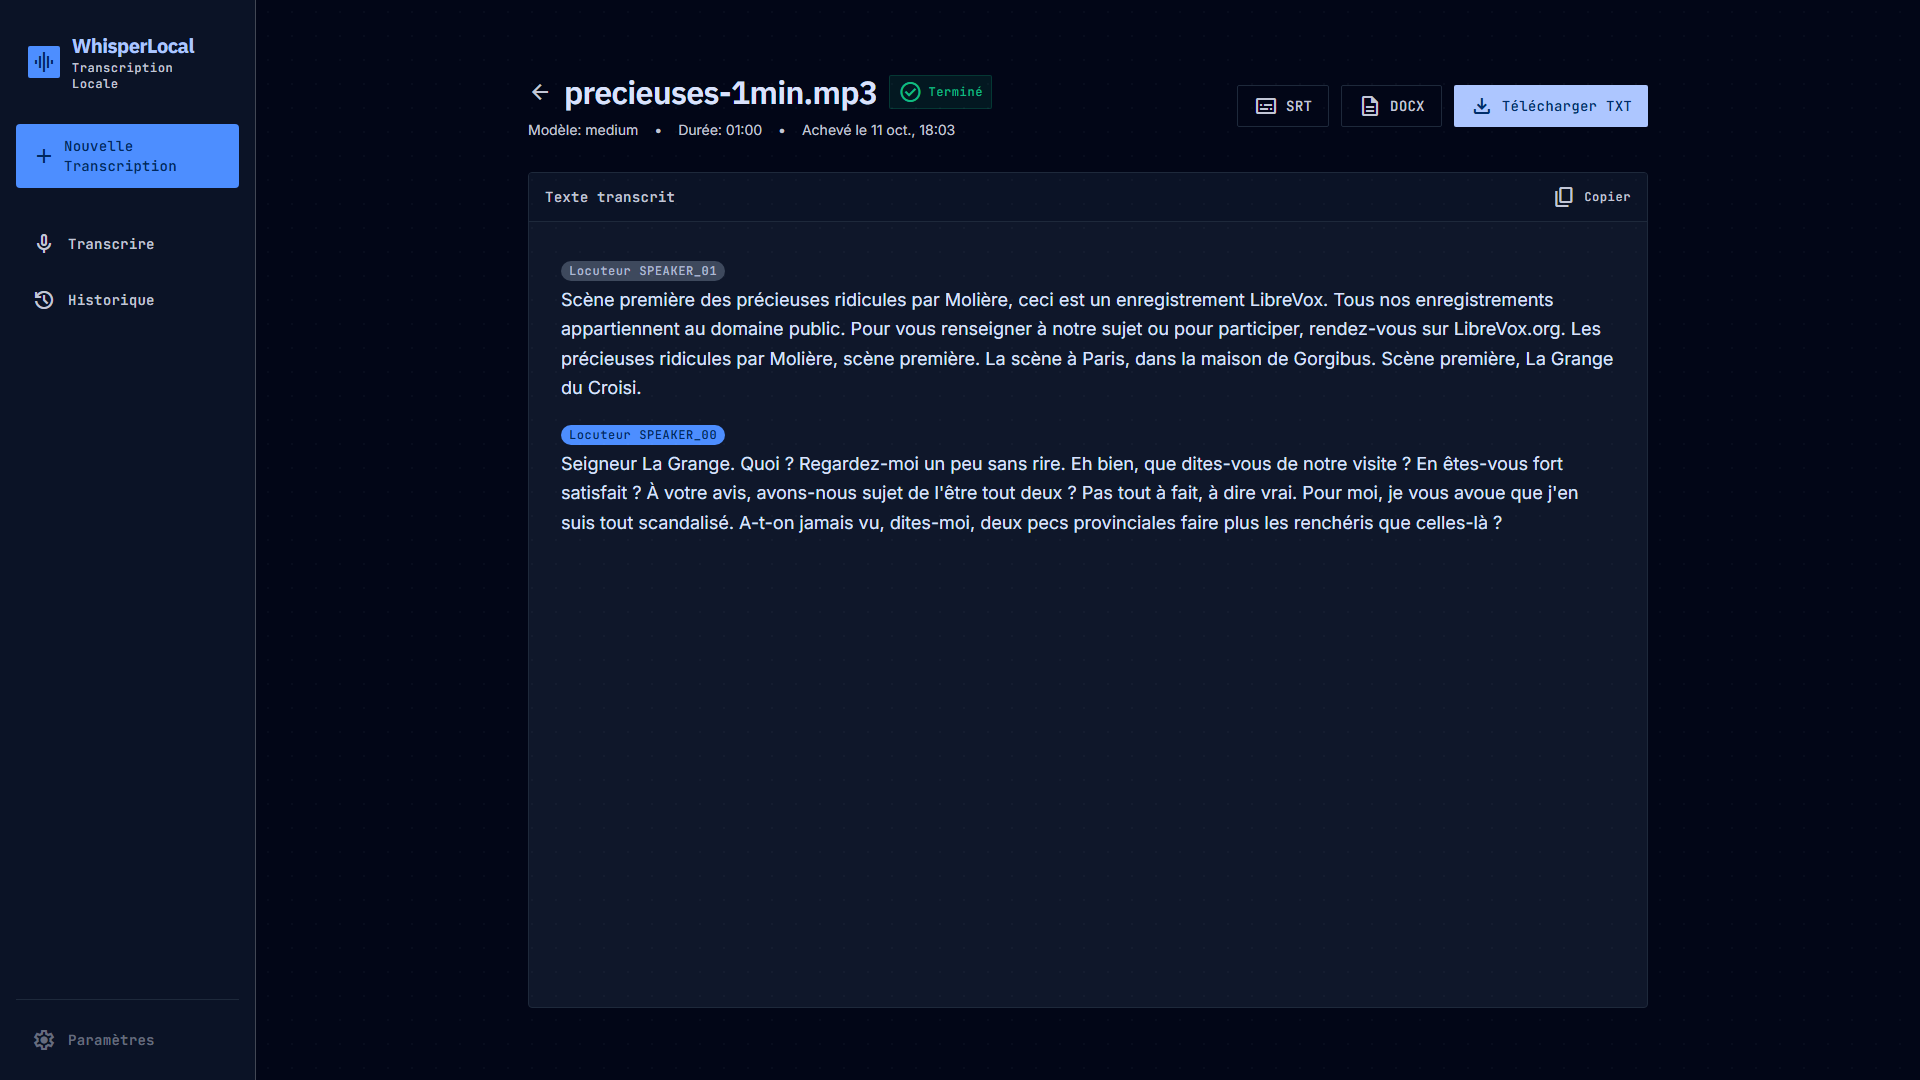
Le texte, avec qui parle quand
Une fois terminé, le texte apparaît découpé par locuteur : ici deux voix distinctes, celle de l'annonce LibriVox puis celle du début de la scène. Le résultat se copie en un clic ou s'exporte en SRT, DOCX ou TXT.
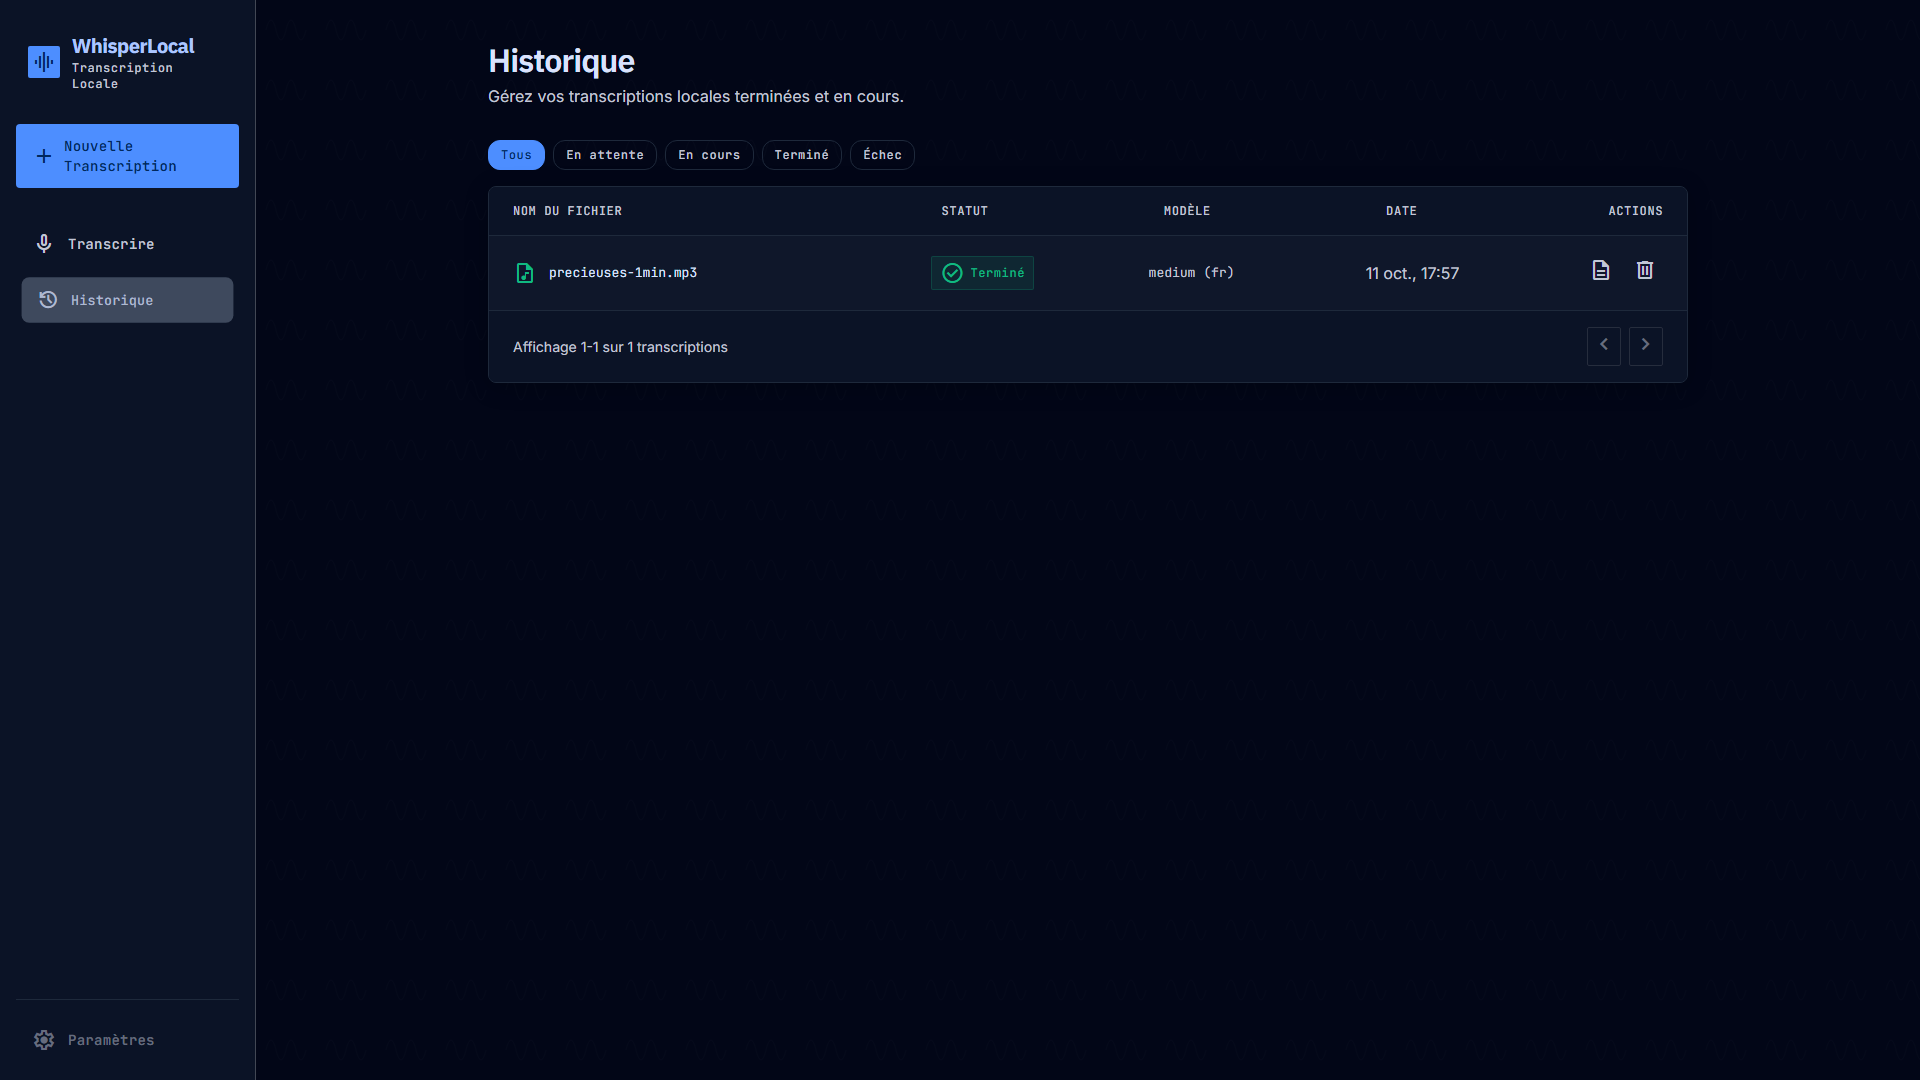
Retrouver ses transcriptions
Chaque job reste dans l'historique avec son statut, son modèle et sa date. On filtre par statut (en attente, en cours, terminé, échec), on rouvre un résultat ou on supprime une entrée.
Quatre conteneurs derrière un seul docker compose up
L'application tourne dans quatre services sur un réseau Docker interne. Le service de diarisation n'est jamais exposé à l'extérieur et son absence ne bloque jamais la transcription : le texte est alors livré sans l'information de locuteur.
| Service | Technologie | Rôle |
|---|---|---|
| Interface | Next.js | Upload, suivi du job, résultat, historique |
| API | NestJS, Prisma | Upload, conversion ffmpeg, appel à whisper.cpp, file d'attente |
| Base de données | PostgreSQL | Historique des jobs, non exposée côté hôte |
| Diarisation | FastAPI, pyannote.audio | Identification des locuteurs, optionnelle et isolée |
Face à un service en ligne
Sur cet extrait, les deux textes sont presque identiques, mot pour mot sur toute la durée. Les écarts sont minimes : le service en ligne écrit correctement le nom Du Croisy, que l'application orthographie Du Croisi. En contrepartie, l'application sépare les voix et le fichier ne quitte jamais l'ordinateur. Ce n'est qu'un test sur une minute d'audio, pas un banc d'essai : il montre que l'approche entièrement locale tient la comparaison pour un usage personnel.
Tout le code et les décisions sont publics
Le dépôt public contient le code complet du frontend et du backend, les décisions d'architecture et leurs justifications (ADR), la documentation technique, le contrat d'API et le schéma de base de données. Le lien du dépôt est dans le résumé, en haut de page.